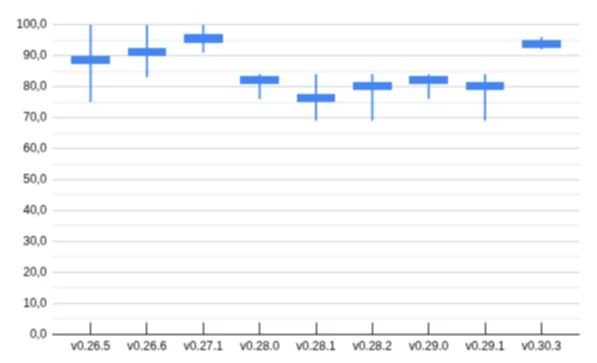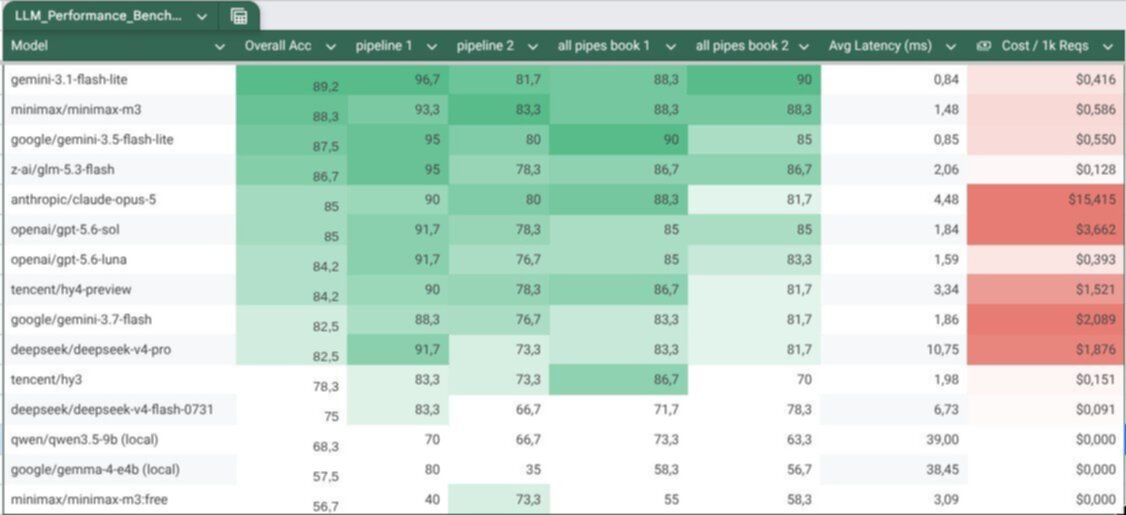
Eu fiz um benchmark para o meu projeto pessoal, e claude opus e gpt sol são horríveis para o meu cenário.
Você já fez o seu benchmark hoje? Essa é uma realidade rotineira para qualquer time que mantém uma feature usando LLM. Todo dia sai modelo novo, e se você está rodando um modelo na nuvem, pode ter atualização sem aviso prévio.
No meu caso eu processo livros, rodando (por enquanto) duas pipelines: a primeira é bem trivial, quase uma classificação em duas etapas, e a outra é mais complexa, com extração de dados em cinco etapas.
Curiosamente, um modelo de maio (gemini-3.1-flash-lite) é o melhor para o meu caso específico. Destaque também para o glm-5.3-flash (Ox Alpha), lançado recentemente. Já modelos mais poderosos, como gpt sol e opus 5, performam bem pior.
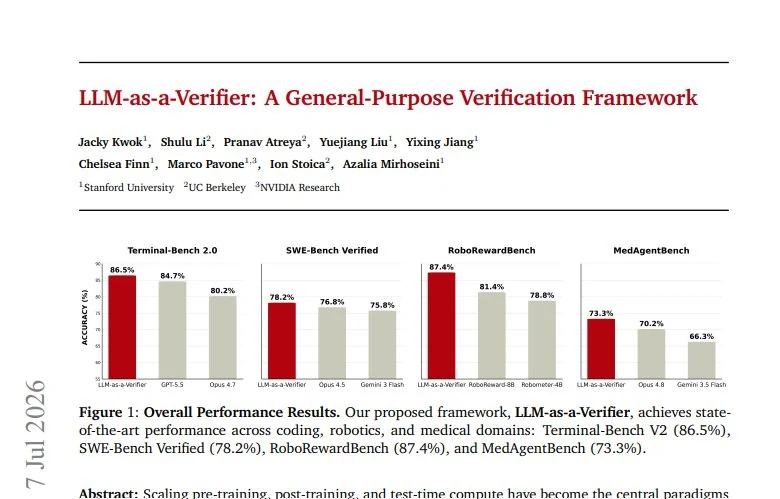
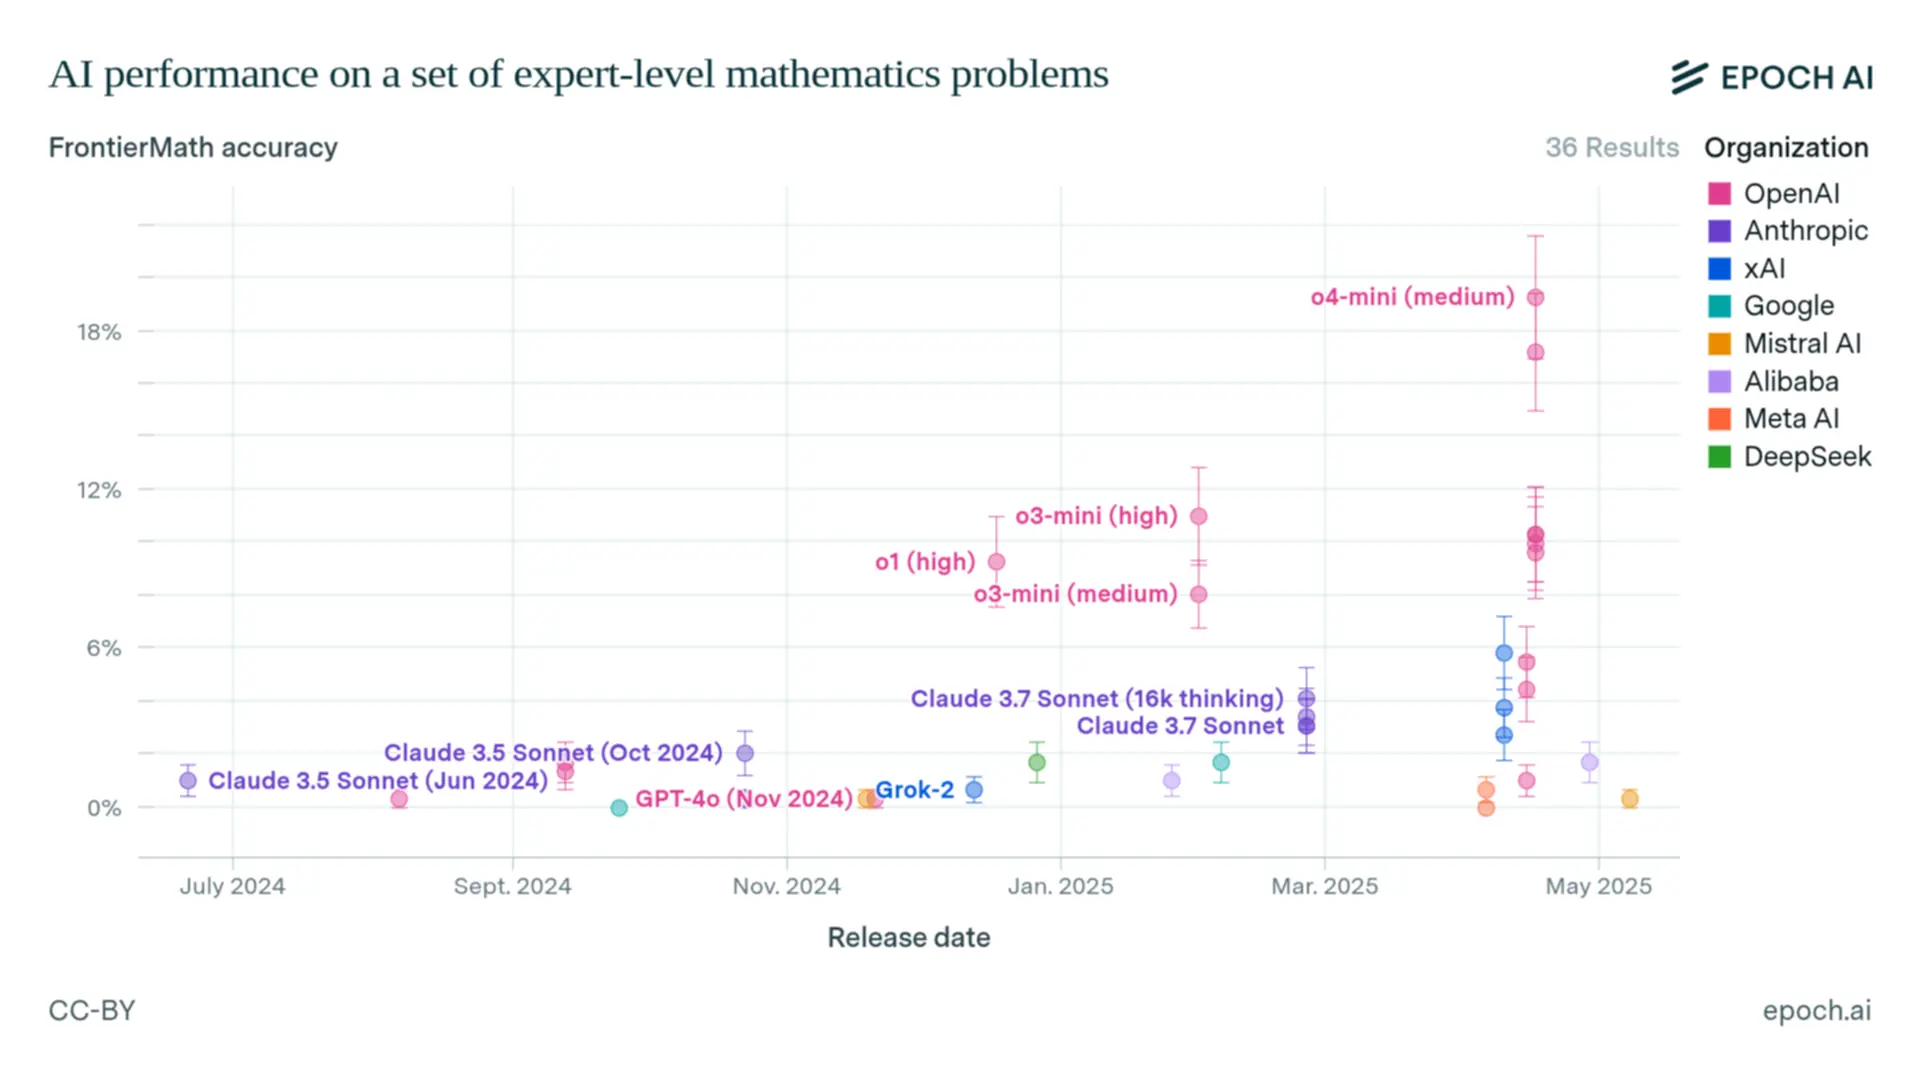
Fica aqui mais um lembrete: pare de prestar atenção cega em benchmarks anunciados em larga escala. Raramente esses benchmarks públicos vão resolver um problema específico da sua empresa. Você é o responsável por saber o que o seu modelo de negócio precisa, fazer o seu próprio benchmark, e descobrir que a realidade é bem diferente.
Como sempre, estou falando aqui de LLM integrada a um sistema, não de produtividade do dia a dia. Uso opus 5 e gpt sol todos os dias e não troco eles por nenhum outro, mas as tarefas do cotidiano e as tarefas que um sistema resolve são coisas bem diferentes.
Como está o seu gold dataset hoje? Se você usa LLM dentro do sistema e não tem um, é simplesmente loucura.